
Muchas empresas medianas generan cada día más datos de los que son capaces de aprovechar: el ERP, el CRM, la web, los ficheros de cada departamento, los registros de las aplicaciones. El valor no está en acumularlos, sino en procesarlos, organizarlos y ponerlos al alcance de quien decide. Para eso hace falta una plataforma de datos: no un repositorio más, sino un ecosistema que gestione el ciclo de vida completo del dato, desde su ingesta hasta su análisis y su uso en modelos de inteligencia artificial.
Este artículo resume, pensando en quien dirige los datos de la organización, qué piezas componen esa plataforma, qué decisiones de arquitectura hay que tomar y en qué orden conviene construirla.
Qué se gana con una plataforma de datos
Para una empresa mediana, la plataforma no es un lujo tecnológico, sino la condición para cuatro cosas:
- Decidir con evidencia: pasar de la intuición a indicadores fiables que guíen la estrategia.
- Ganar eficiencia operativa: automatizar procesos y optimizar recursos con información actualizada.
- Innovar: diseñar productos y servicios a partir del comportamiento de los clientes y del mercado.
- Dar autonomía al negocio: que los equipos exploren sus propios datos sin depender siempre de TI.
Las tres capas de la plataforma
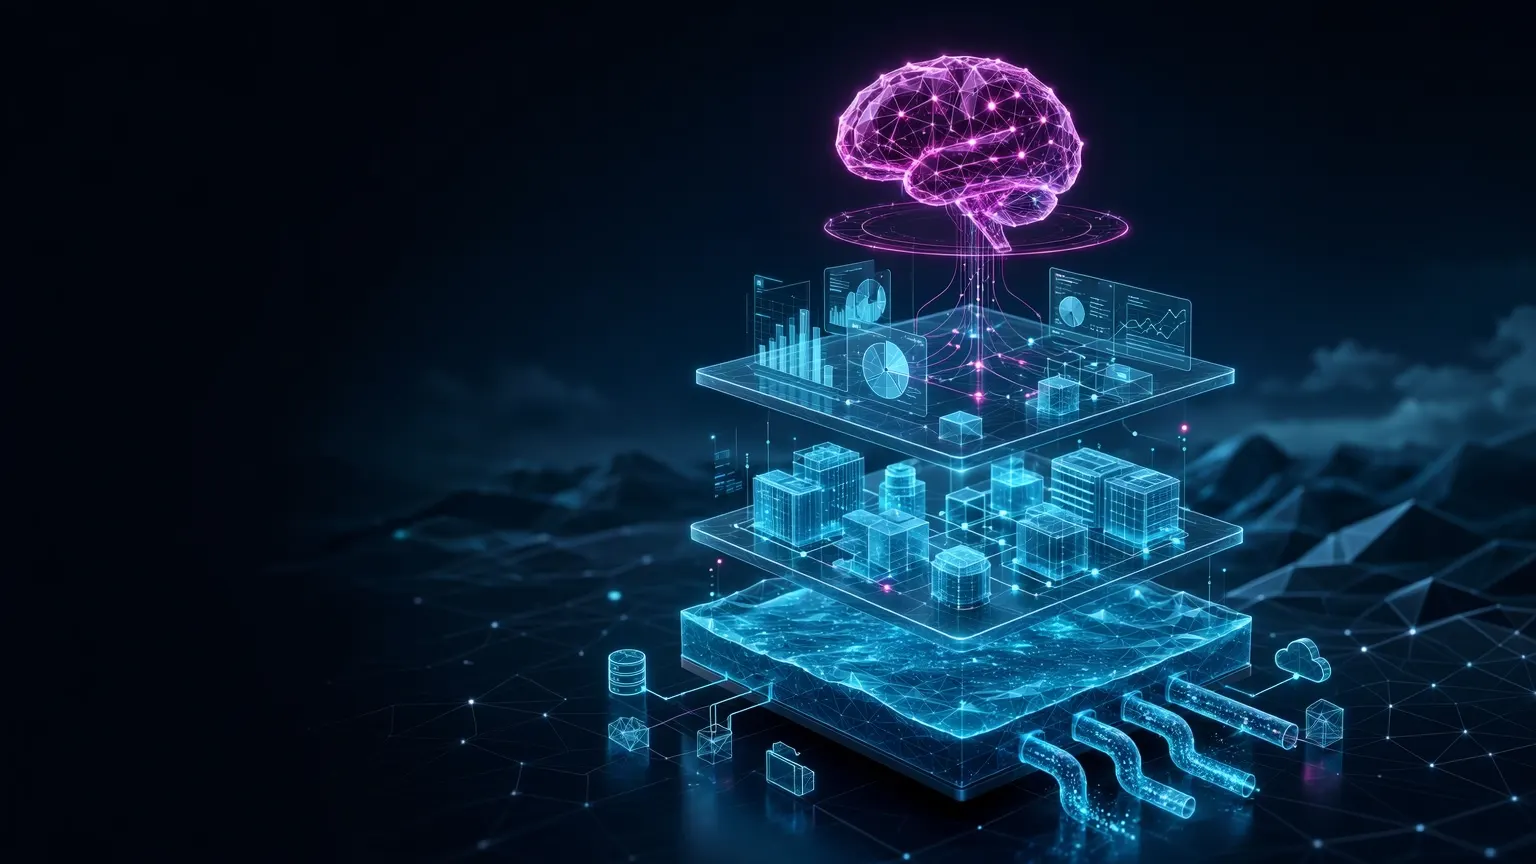
Una plataforma de datos completa se organiza en tres capas que funcionan de forma conectada:
| Capa | Función | Componentes principales |
|---|---|---|
| Ingesta y almacenamiento | Recoger, centralizar y conservar los datos de todas las fuentes con integridad y disponibilidad | Fuentes (bases de datos operativas, API, registros, redes sociales, flujos en tiempo real), data lake, data warehouse, procesos ETL/ELT |
| Proceso y gobierno | Convertir el dato en información útil y fiable | Motor de proceso (limpieza, enriquecimiento, agregación), catálogo de datos, políticas de seguridad y cumplimiento |
| Consumo y analítica | Poner el valor al alcance del usuario final | Cuadros de mando e informes, analítica de autoservicio, plataforma de IA |
El orden importa: si la base falla, nada de lo que se construya encima será fiable.
La base: data lake, data warehouse o lakehouse
La primera decisión de arquitectura es dónde y cómo se almacenan los datos.
| Data lake | Data warehouse | |
|---|---|---|
| Qué guarda | Grandes volúmenes de datos brutos, estructurados o no | Datos estructurados y modelados |
| Esquema | No exige un esquema previo | Esquema definido de antemano |
| Para qué sirve | Flexibilidad y análisis futuros, ciencia de datos | Informes y análisis de negocio recurrentes |
| Ejemplos en la nube | Azure Data Lake Storage, Google Cloud Storage, Amazon S3 | Azure Synapse Analytics, Google BigQuery, Amazon Redshift |
| Opciones de código abierto | Hadoop HDFS, Apache Iceberg, Delta Lake | Apache Druid, ClickHouse |
La tendencia actual es la arquitectura lakehouse, que combina la flexibilidad del data lake con la gestión y el rendimiento analítico del data warehouse. En la práctica, permite guardar los datos una sola vez, en formatos abiertos, y servirlos tanto a los informes como a los modelos de IA.
ETL o ELT
Para mover los datos entre sistemas hay dos enfoques:
- ETL (extraer, transformar, cargar): los datos se transforman antes de llegar al destino. Es habitual con datos estructurados y reglas estables.
- ELT (extraer, cargar, transformar): los datos se cargan primero en el data lake y se transforman allí. Encaja mejor con datos semiestructurados y con arquitecturas lakehouse, porque conserva el dato original y permite rehacer transformaciones.
La capa de consumo: analítica de autoservicio
Es la cara visible de la plataforma, la que traduce la complejidad técnica en respuestas para el negocio. El autoservicio permite que los usuarios hagan sus propias consultas y análisis sin pasar por TI, lo que aporta agilidad (respuestas más rápidas), autonomía (curiosidad y experimentación) y eficiencia (TI se dedica a tareas de más valor).
Una buena herramienta de BI debe ofrecer visualización clara de datos complejos, interactividad (filtros y navegación al detalle) y conexión a varias fuentes a la vez. Entre las más extendidas están Microsoft Power BI, con fuerte integración en el ecosistema Microsoft; Google Looker Studio, sencilla y muy ligada a Google Analytics y BigQuery; Amazon QuickSight, con capacidades de IA integradas; y Apache Superset, de código abierto y muy personalizable.
El autoservicio funciona cuando hay modelos de datos comunes y validados debajo. Sin ellos, cada área construye su versión de los indicadores y los números dejan de cuadrar.
Nube o código abierto
La elección depende del presupuesto, de los recursos técnicos internos y de los objetivos a largo plazo.
| Plataforma en la nube | Código abierto | |
|---|---|---|
| Ventajas | Escalado automático, mantenimiento a cargo del proveedor, seguridad preconfigurada, servicios integrados | Sin coste de licencias, control total de la tecnología, alta personalización |
| Inconvenientes | Coste variable según el uso, riesgo de dependencia del proveedor | Exige un equipo técnico especializado, implantación más lenta, toda la responsabilidad de la seguridad |
Entre los grandes proveedores, Microsoft Azure destaca por su integración con el ecosistema Microsoft (con Microsoft Fabric como apuesta por unificar sus servicios de datos), Google Cloud por sus capacidades de IA y el rendimiento de BigQuery en consultas a gran escala, y AWS por la amplitud y madurez de su catálogo de servicios. Para muchas empresas medianas, el criterio decisivo es el ecosistema que ya usan y las capacidades del equipo que va a mantener la plataforma.
La plataforma de inteligencia artificial
Una plataforma de datos moderna no está completa sin capacidades de IA, y desplegar modelos exige gestionar su ciclo de vida (lo que se conoce como MLOps). Sus piezas básicas son cuatro:
- Construcción de modelos: entornos para entrenar y evaluar modelos de clasificación, regresión, agrupación o generativos.
- Repositorio de modelos: un lugar central para guardar los modelos entrenados y sus versiones.
- Despliegue: exponer los modelos como servicios (API) que otras aplicaciones puedan consumir.
- Monitorización: vigilar el rendimiento en producción y detectar desviaciones.
Los grandes proveedores ofrecen entornos completos para ello, como Azure Machine Learning, Vertex AI o Amazon SageMaker. El ciclo se cierra con la retroalimentación: los datos del data warehouse alimentan el entrenamiento, los modelos se despliegan y se vigilan, y lo aprendido en producción mejora la siguiente versión.
Con esta base se abren casos de uso como la personalización de la experiencia del cliente, la detección de anomalías en tiempo real, la automatización inteligente de procesos o el análisis predictivo para la toma de decisiones.
Agentes de IA sobre los datos de la empresa
Un paso más es desplegar agentes de IA que permitan a los empleados interactuar con los datos de forma conversacional: un asistente que responde preguntas sobre las ventas a partir del data warehouse, o un agente que resume a diario los informes o la documentación técnica. Estos agentes necesitan una arquitectura que les dé acceso a los datos de manera segura y controlada, respetando los mismos permisos y la misma clasificación que se aplican a las personas.
La cultura de datos: la pieza que no se compra
La tecnología, por sí sola, no genera valor; lo genera la gente que la usa. Dos prácticas ayudan a consolidar la cultura de datos:
- Un repositorio de conocimiento: una wiki interna donde se documentan las definiciones de los indicadores, el linaje de los datos y los manuales de uso.
- Comunidades de práctica: grupos transversales donde negocio y equipos de datos comparten análisis, resuelven problemas y aprenden unos de otros.
Una hoja de ruta por fases
La plataforma se construye de forma incremental y orientada al valor. Un enfoque por fases reduce riesgos y facilita la adopción:
| Fase | Objetivo | Actividades |
|---|---|---|
| 1. Preparación y descubrimiento | Sentar las bases | Definir indicadores y casos de uso de alto impacto, inventariar fuentes internas y externas, evaluar nube frente a código abierto |
| 2. Producto mínimo viable | Demostrar valor pronto con un piloto | Montar la base de almacenamiento, construir los procesos de carga del piloto, desarrollar el cuadro de mando piloto y validarlo con usuarios |
| 3. Escalado e integración | Llegar a más áreas de negocio | Integrar nuevas fuentes (ERP, CRM), implantar el gobierno y el catálogo de datos, formar a los usuarios de negocio |
| 4. IA y automatización | Automatizar procesos con modelos | Desarrollar modelos (predicción de ventas, segmentación), establecer MLOps, desplegar agentes de IA para la gestión del conocimiento |
La duración de cada fase depende del punto de partida, del número de fuentes y de los recursos disponibles; lo importante es que cada una termine con algo que el negocio use.
Por dónde empezar
Una plataforma de datos e IA no es un proyecto que se entrega y se cierra, sino un recorrido continuo. El enfoque más eficaz para una empresa mediana es elegir uno o dos casos de uso con impacto claro, construir un piloto que los resuelva de principio a fin y crecer sobre lo que ya funciona, incorporando gobierno y cultura de datos desde el principio y no al final. En Bidatia acompañamos a las organizaciones en ese camino, desde el diseño de la arquitectura hasta la puesta en marcha de los primeros casos de uso.
Preguntas frecuentes
¿Qué diferencia hay entre un data lake, un data warehouse y un lakehouse?
El data lake guarda grandes volúmenes de datos brutos sin esquema previo; el data warehouse guarda datos estructurados y modelados para informes. El lakehouse combina ambos: almacena los datos una vez, en formatos abiertos, y ofrece la gestión y el rendimiento analítico de un data warehouse.
¿Es mejor una plataforma en la nube o una de código abierto?
Depende del presupuesto, del equipo y de los objetivos. La nube aporta escalado y mantenimiento gestionado a cambio de costes variables y cierta dependencia del proveedor; el código abierto evita licencias y da control total, pero exige un equipo especializado y asume toda la responsabilidad de la seguridad.
¿Qué es MLOps y por qué hace falta?
Es la gestión del ciclo de vida de los modelos de IA: construcción, versionado, despliegue y monitorización. Sin MLOps, los modelos se quedan en pruebas de laboratorio o se degradan en producción sin que nadie lo advierta.
¿Por dónde debería empezar una empresa mediana?
Por uno o dos casos de uso de alto impacto y un inventario de sus fuentes de datos. Con eso se construye un piloto que demuestre valor y, a partir de ahí, se amplía la plataforma a más áreas y se incorporan la IA y la automatización.