
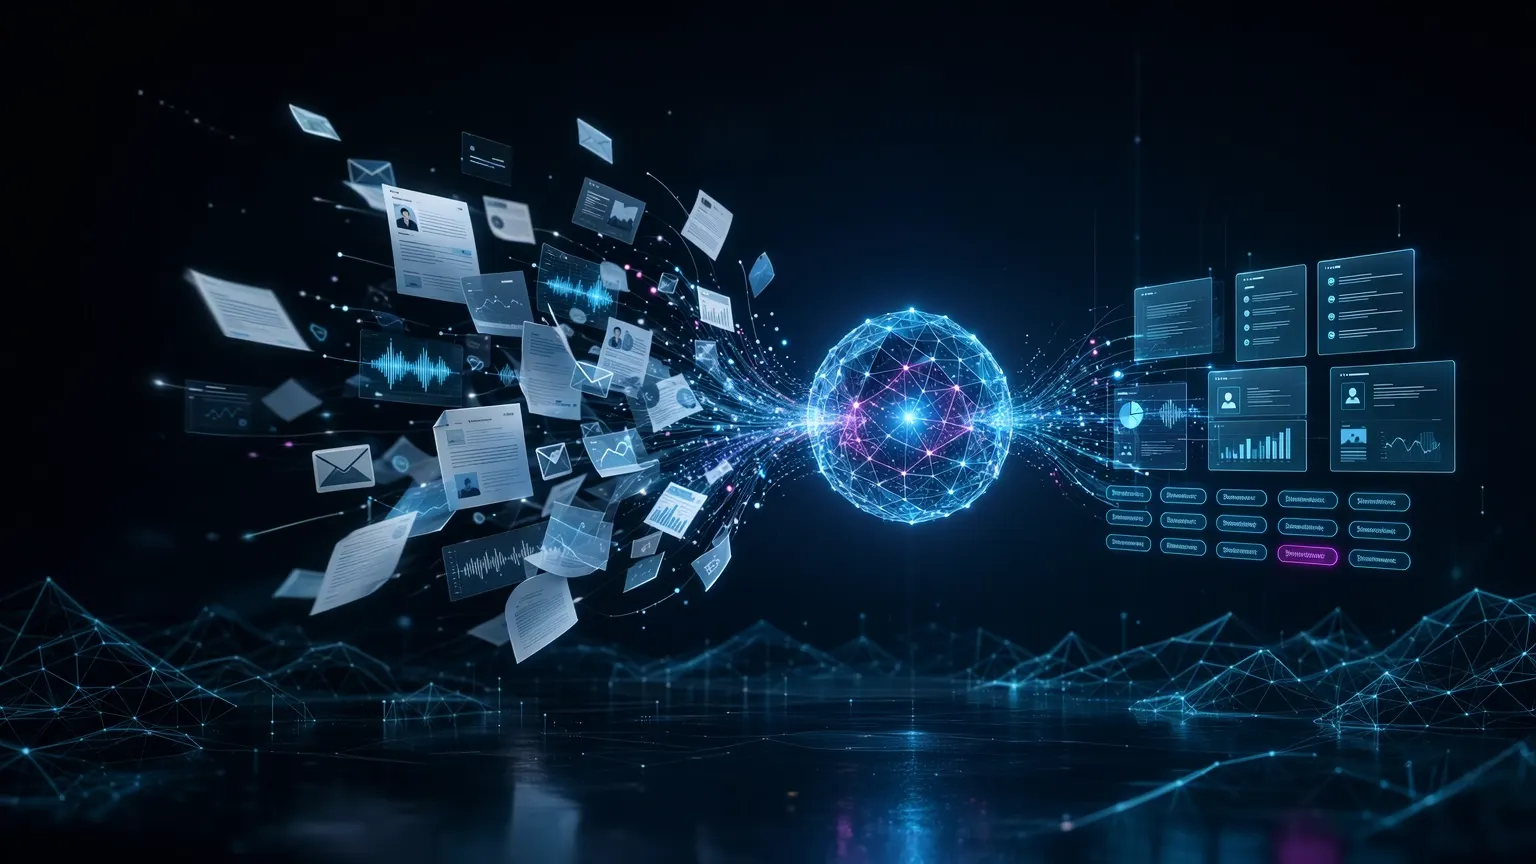
Las decisiones de negocio se apoyan sobre todo en datos estructurados: tablas de ventas, pedidos, facturas. Pero buena parte de lo que una organización sabe está en otro sitio: grabaciones de llamadas, contratos en PDF, correos, actas de reunión, comentarios de clientes en redes sociales. Ese contenido no estructurado es, en la práctica, invisible para la automatización: ningún informe lo resume y ningún proceso reacciona a lo que dice.
Lo que falta para aprovecharlo son metadatos: campos concretos que describen el contenido y que un sistema sí puede usar. «Intención del cliente», «motivo de baja», «cláusula de penalización no estándar». Hasta ahora, crear esos metadatos exigía que alguien leyera o escuchara cada pieza, algo lento, caro e imposible de escalar. Los agentes de IA generativa cambian esa ecuación.
El problema: metadatos que no se pueden crear a mano
| Fuente | Qué contiene | Metadato que interesa |
|---|---|---|
| Transcripciones de atención al cliente | Quejas, dudas, intención de compra o de baja | Motivo de contacto, nivel de frustración, riesgo de abandono |
| Contratos y documentos legales | Cláusulas, plazos, obligaciones | Tipo de cláusula, desviación respecto al modelo propio, nivel de riesgo |
| Correos y tickets | Peticiones e incidencias | Categoría, urgencia, área responsable |
| Actas e informes técnicos | Decisiones y compromisos | Acuerdos, responsables, plazos, discrepancias |
| Tablas de la plataforma de datos sin documentar | Columnas con nombres crípticos | Finalidad de la columna, proceso que la alimenta, propietario probable |
Cuando la creación de metadatos no escala, el negocio reacciona tarde: la señal de que un cliente va a irse estaba en la llamada de la semana pasada, y el riesgo del contrato estaba en la página 14.
Qué es un agente de IA generativa (y qué no es)
Un agente no es un chatbot. Es un sistema que convierte una tarea de negocio en una secuencia de acciones y la ejecuta de principio a fin. Impulsado por un modelo de lenguaje, el agente es capaz de:
- Razonar y planificar: descomponer la tarea en pasos lógicos.
- Actuar: usar herramientas y API de los sistemas de la empresa, como el CRM, el ERP o el gestor documental.
- Iterar: revisar los resultados intermedios y corregir el plan.
La diferencia práctica es clara. Un chatbot responde «esta llamada parece una queja por facturación». Un agente analiza todas las grabaciones de la semana, extrae los campos definidos, actualiza el CRM y deja constancia de en qué fragmento se basa cada valor.
La pila técnica tiene dos capas:
- El modelo (el cerebro): un modelo de lenguaje con capacidad de razonamiento y, si hace falta, multimodal para audio e imágenes.
- La orquestación (el cuerpo): plataformas como LangChain o n8n, o servicios equivalentes de los grandes proveedores de nube, que definen el flujo de trabajo y conectan el agente con los sistemas de destino.
RAG: precisión con información propia
Un modelo de lenguaje no conoce los contratos, las políticas ni los procedimientos de una organización, y si se le pregunta por ellos puede inventar una respuesta verosímil. La técnica que resuelve esto es la generación aumentada por recuperación (RAG):
- Consulta. El agente recibe una tarea concreta: «localiza la cláusula de indemnización en este contrato».
- Recuperación. El sistema busca los fragmentos relevantes en la base de conocimiento de la organización: documentos, bases de datos, el lago de datos.
- Aumento. El modelo recibe la petición junto con esos fragmentos.
- Generación. El modelo devuelve la respuesta o el metadato estructurado, citando las fuentes internas en que se basa.
RAG se ha convertido en el enfoque de referencia para usar IA generativa con información propia: mantiene los datos bajo control de la organización, evita depender de lo que el modelo aprendió en su entrenamiento y hace que cada resultado sea verificable. No elimina los errores, pero los hace detectables.
Cuatro casos de uso de alto valor
1. Atención al cliente y ventas
A partir de transcripciones, el agente extrae campos como motivo de contacto, nivel de frustración en una escala definida, motivo de cancelación o calificación del contacto comercial. Con esos campos en el CRM se pueden detectar a tiempo los clientes en riesgo de abandono y orientar la formación de los equipos con casos reales.
2. Contratación y área legal
Sobre contratos en PDF, el agente identifica cláusulas, las clasifica y marca desviaciones respecto al modelo propio de la organización o cláusulas de riesgo. Las revisiones documentales, como una due diligence, se aceleran mucho, y cada hallazgo queda enlazado al fragmento exacto del documento gracias a RAG.
3. Documentación de la plataforma de datos
Muchas tablas de un lago o almacén de datos carecen de documentación. Un agente puede proponer la finalidad de cada columna, el proceso de negocio que la alimenta y un propietario probable, a partir del esquema, del código de carga y de la documentación disponible. Son propuestas que el administrador del dato valida, pero ahorran la parte más tediosa y aceleran el catálogo y el cumplimiento del RGPD. Para el modelo de metadatos de destino, consulta gestión de metadatos y catálogo de datos.
4. Análisis de varias fuentes a la vez
El agente compara, por ejemplo, un informe técnico, la normativa aplicable y las notas de una reunión, y extrae diferencias clave y posibles incumplimientos. Es una tarea que una persona puede hacer, pero no sobre decenas de documentos a la vez ni cada vez que uno de ellos cambia.
Cómo asegurar la calidad de los metadatos
Un metadato que nadie se fía de usar no sirve. Algunas prácticas que marcan la diferencia:
- Esquema cerrado. Definir de antemano los campos y sus valores permitidos (listas controladas, escalas) y obligar al modelo a devolver exactamente ese formato.
- Fuente citada. Cada valor lleva la referencia al fragmento de origen, para que la revisión sea rápida.
- Muestra validada. Medir la precisión contra un conjunto revisado por personas expertas antes de automatizar, y repetir la medición periódicamente.
- Revisión humana proporcional al riesgo. Validación sistemática en lo legal o lo que afecte a derechos; muestreo en lo operativo.
- Datos personales bajo control. Transcripciones y correos contienen datos personales: minimizar lo que se envía al modelo, controlar dónde se procesa y quién ve los resultados.
Hoja de ruta de adopción
| Fase | Foco | Quién participa |
|---|---|---|
| 1. Descubrimiento | Demostrar valor en un caso de bajo riesgo, por ejemplo clasificar un lote de documentos | Innovación y el área de negocio implicada |
| 2. Industrialización de RAG | Construir la base de conocimiento segura y la arquitectura RAG con trazabilidad | Arquitectura de datos, seguridad |
| 3. Agentes piloto | Desplegar agentes en los casos prioritarios y medir indicadores de eficiencia y de calidad | Negocio, datos, seguridad |
| 4. Escala | Integrar agentes en procesos completos, con más autonomía, auditoría y gobierno de la IA | Toda la organización, con un marco de gobierno estable |
Cada fase debería cerrarse con resultados medidos (precisión, tiempo ahorrado, adopción) antes de pasar a la siguiente.
Por dónde empezar
La pregunta útil no es «qué podemos hacer con IA», sino «qué metadato nos falta y cuánto vale tenerlo». Un buen punto de partida es elegir ese metadato en el área donde más duele (atención al cliente o contratos, normalmente), definir su esquema, preparar una muestra validada y construir una prueba de concepto que mida la precisión con datos reales. En Bidatia acompañamos este tipo de proyectos, desde la elección del caso hasta su integración con la plataforma y el gobierno del dato.
Preguntas frecuentes
¿Qué es un metadato extraído con IA?
Un dato estructurado que un agente obtiene leyendo contenido no estructurado: por ejemplo, el motivo de una llamada a partir de su transcripción, o el tipo de penalización de un contrato a partir del PDF. Se guarda en un campo concreto del CRM, del gestor documental o del catálogo de datos, con referencia a la fuente.
¿RAG elimina las alucinaciones?
No las elimina, pero las reduce mucho, porque el modelo responde a partir de fragmentos recuperados de las fuentes de la organización y puede citarlos. Para metadatos con consecuencias, como el riesgo de una cláusula, conviene mantener revisión humana y medir la precisión con una muestra validada.
¿Qué caso de uso conviene elegir para empezar?
Uno de bajo riesgo, con un volumen suficiente de documentos y un resultado fácil de comprobar: clasificar un lote de documentos por tipo o extraer unos pocos campos de un conjunto de contratos. Permite medir la calidad antes de tocar procesos críticos.
¿Qué pasa con los datos personales de grabaciones y correos?
Las transcripciones y los correos suelen contener datos personales, a veces sensibles. Antes de procesarlos hay que revisar la base jurídica, minimizar lo que se envía al modelo, controlar dónde se procesa y quién accede a los resultados, y valorar si hace falta una evaluación de impacto.